- 입력 2026.10.29 02:01
vLLM 플러그인 연동으로 기존 코드 수정 없이 NPU 도입 가능
프리필·디코드 분리 병렬화 지원해 대규모 추론 효율 개선
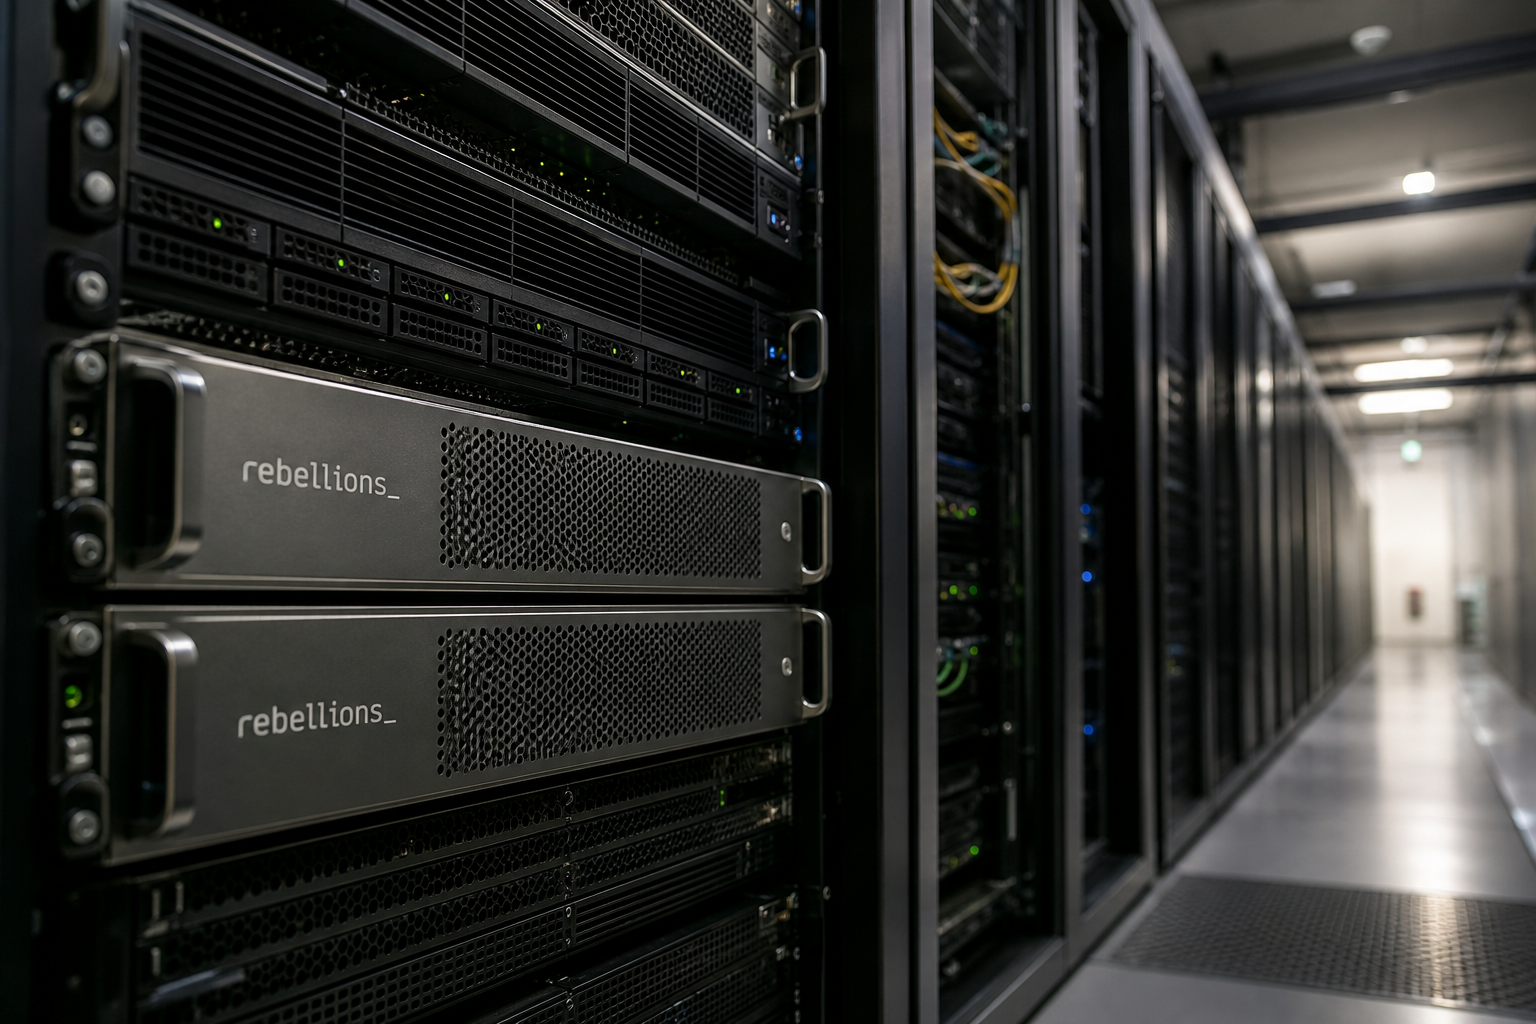
국내 인공지능(AI) 반도체 스타트업 리벨리온의 신경망처리장치(NPU)가 쿠버네티스(Kubernetes) 기반 분산 대형언어모델(LLM) 추론 프레임워크인 'llm-d' 버전 1.0.0의 공식 하드웨어로 정식 채택됐다. 글로벌 빅테크가 주도하는 오픈소스 생태계에 표준 방식으로 편입되면서, 글로벌 AI 인프라 시장 진입을 위한 발판을 마련한 것으로 풀이된다.
28일 리벨리온 공식 소셜네트워크서비스(SNS)에 따르면 회사는 이 같은 사실을 발표했다. 'llm-d'는 구글, 레드햇, IBM 리서치, 엔비디아 등이 공동 개발해 클라우드 네이티브 컴퓨팅 재단(CNCF) 샌드박스 프로젝트로 운영 중인 오픈소스 프레임워크다. 25개 이상 조직에서 500명 이상의 기여자가 참여해 대규모 클러스터 환경의 LLM 추론 분산 처리를 돕는다. 이번 v1.0.0 정식 출시와 함께 리벨리온 NPU는 엔비디아 그래픽처리장치(GPU), 구글 텐서처리장치(TPU) 등과 나란히 공식 지원 가속기 목록에 이름을 올렸다.
리벨리온은 AI 모델 구동 도구인 'vLLM' 플러그인 아키텍처를 통해 자사 NPU를 llm-d에 연동했다. 개발자들은 별도의 독자적인 포크(Fork·소프트웨어 코드를 복사해 독립적인 버전을 만드는 것)를 유지할 필요 없이, 표준 쿠버네티스 환경에서 기존 워크플로우 그대로 리벨리온 하드웨어를 도입할 수 있다. 새로운 AI 가속기를 채택할 때 발생하는 소프트웨어 호환성 문제와 코드 수정 부담을 줄였다.
이번 연동으로 '프리필(Prefill)과 디코드(Decode) 분리 병렬화' 추론 기능이 리벨리온 NPU 환경에서도 지원된다. LLM 추론 과정에서 연산량이 많은 프리필 단계와 메모리 대역폭이 중요한 디코드 단계를 서로 다른 노드나 가속기 풀에서 분리해 처리하는 기술이다. 이를 통해 다수의 가속기로 구성된 클러스터 전반의 자원 활용도를 높이고 응답 지연을 줄일 수 있다. 최대 8장의 카드로 512GB(기가바이트) 메모리를 지원하는 리벨리온의 '아톰-맥스(ATOM-Max)' 서버 등을 활용할 경우 대규모 트래픽 환경에서도 안정적인 서비스가 가능하다.
최근 AI 서비스가 텍스트 생성뿐만 아니라 다단계 에이전트(Agent)와 멀티모달 처리 등으로 복잡해지면서 분산 추론 기술의 중요성이 커지고 있다. 구글 클라우드 공식 블로그에 따르면, llm-d는 캐시 인식 라우팅과 트래픽 제어 기능을 통해 복잡한 추론 요청으로 인한 병목 현상을 해결한다. 리벨리온은 자사의 고효율 NPU 하드웨어와 llm-d의 분산 오케스트레이션 역량을 결합해, 기업 고객이 대규모 AI 인프라의 총소유비용(TCO)을 절감할 수 있도록 지원할 계획이다.
llm-d 공식 가속기 문서(Official Accelerators Documentation)는 "리벨리온 NPU는 vLLM 플러그인 아키텍처를 통해 llm-d에서 공식 지원된다"며 "사용자는 독자적인 포크를 유지할 필요 없이 표준 쿠버네티스 매니페스트를 사용해 리벨리온 하드웨어에 모델을 배포할 수 있다"고 명시했다. 이어 "다중 가속기 클러스터 전반에서 프리필 및 디코드 분리를 활성화할 수 있다"고 덧붙였다.
리벨리온은 공식 SNS를 통해 "새로운 AI 가속기를 도입한다고 해서 기존 추론 워크플로우를 변경해야만 하는 것은 아니다"라고 강조했다. 회사는 "우리는 개방형 표준과 기존 소프트웨어 생태계를 기반으로 구축하는 것을 중요하게 생각하며, 이를 통해 개발자가 새로운 하드웨어를 AI 인프라에 더 쉽게 통합할 수 있도록 지원한다"고 설명했다.